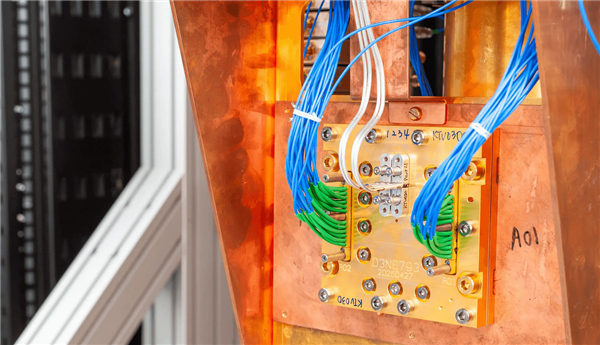
头条 IBM首次接通两颗量子芯片 99%精度跨芯片量子态传输 10月29日消息,IBM工程师近日首次将两个独立的量子处理器连接起来,实现了跨芯片的量子态传输与纠缠,为模块化量子计算机架构扫清了关键障碍。相关论文已发布在arXiv预印本平台,尚未经过同行评审。 最新资讯 工业自动化软件突破“卡脖子”进入快车道 今年“两会”期间,在科技自立自强、制造业转型升级的大背景下,解决工业软件“卡脖子”成为代表委员们的高频提案,也成为社会各界讨论的热门话题。 比如,全国政协委员许进表示,工业软件亟需尽快突破“卡脖子”问题。他说,“目前,我国90%以上工业软件仍需进口,部分自主软件模块在国外的基础软件平台上进行二次开发,对于工业发展具有不自主可控性。” 又如,全国政协委员王明凡指出,要让“卡脖子”技术实现国产替代。他称,“当前,我国工业基础领域面临一些‘卡脖子’问题,特别是在基础工业软件、关键材料和高端装备等方面对进口的依赖较为严重。” 发表于:2024/3/21 三星半导体公布新品路线图 3 月 21 日消息,三星半导体日前在官方公众号上公布了新品路线图,其中包含了 UFS 4.0 4 和 UFS 5.0 。 发表于:2024/3/21 英特尔:32G将成AI PC入门级标配 3月21日消息,日前,2024中国闪存市场峰会在深圳举行,本届峰会主题为“存储周期 激发潜能”。 据媒体报道,英特尔中国区技术部总经理高宇在峰会上表示,未来入门级AI PC一定是标配32G内存,当前16G内存一定会被淘汰。 发表于:2024/3/21 国内首枚,硅臻芯片量子芯片通过国家商密检测 国内首枚,硅臻芯片量子芯片通过国家商密检测 发表于:2024/3/21 更快更小!三星二代QLC闪存技术公开:速度直接翻倍! 更快更小!三星二代QLC闪存技术公开:速度直接翻倍! 3 月 21 日消息,根据三星半导体近日在官方公众号公布的新品线路图显示,三星将计划推出 UFS 4.0 以及 UFS 5.0。 发表于:2024/3/21 三星正研发 CMM-H 混合存储模组 3 月 21 日消息,据三星半导体微信公众号发布的中国闪存市场峰会 2024 简报,其正研发 CMM-H 混合存储 CXL 模组。该模组同时包含 DRAM 内存和 NAND 闪存。 作为一种新型高速互联技术,CXL 可提供更高的数据吞吐量和更低的传输延迟,可在 CPU 和外部设备间建立高效连接。 根据三星给出的图示,这一模组可经由 CXL 界面直接在闪存部分和 CPU 之间传输块 I / O,也可经由 DRAM 缓存和 CXL 界面实现 64 字节的内存 I / O 传输。 发表于:2024/3/21 多源极轨卫星微波温度计资料实时区域同化系统 基于中尺度数值预报模式WRF和WRFDA同化系统,实现多源极轨卫星微波温度计资料实时区域同化,并对同化产品进行评估和应用。2018年同化试验结果表明:通过质量控制和偏差订正,AMSU-A资料第5~9通道亮温观测增量O-B(观测值O和背景场的正演辐射模拟值B的差值)的标准差有效降低,同化后各通道亮温分析残差O-A(观测值O和分析场的正演辐射模拟值A的差值)的标准差有效降低。同化预报产品被应用在暴雨强对流个例和台风个例中,取得良好效果。 发表于:2024/3/20 基于改进YOLOv5的路面裂缝检测方法 针对现有裂缝检测模型体积较大且检测精度不高的问题,提出一种基于轻量化网络的无人机航拍图像裂缝检测方法。首先,使用MobileNetv3网络替代YOLOv5的主干网络,降低模型大小;其次,引入C3TR和CBAM模块提高网络表征能力,将损失函数替换为EIOU以提高模型的鲁棒性。实验结果表明,该方法在自制数据集上获得98.9%的精度,相较于原始YOLOv5提高1.2%,模型大小减小51.5%,检测速度提高37%。改进后的模型在精度、大小和速度上均优于Faster-RCNN等4种常见裂缝检测模型,满足了裂缝检测的实时性、轻量化和精度需求。 发表于:2024/3/20 三星正打造全新的PB级别SSD存储方案 3月19日消息,三星宣布,正在打造全新的PB级别SSD存储方案,也就是PBSSD,容量将达到跨越式的1PB左右,相当于1000TB。 三星并未透露具体如何实现PBSSD,只是说将会利用其开发的FDP(Flexible Data Placement)技术,可以翻译为弹性数据安置,已经被采纳为NVMe技术标准。 它可以强化数据的存储能力,从而提高性能和可预见性,更好地满足超大规模工作负载的需求,尤其是配合超强算力的AI GPU。 事实上,三星这一番表态,就是在NVIDIA GTC大会上做出的,后者刚发布了新一代高性能GPU B100/B200和超级芯片GB200。 发表于:2024/3/20 RTX 50升级台积电4NP工艺:但其实还是5nm 3月20日消息,NVIDIA刚发布的B100/B200 AI GPU将制造工艺从4N升级到4NP,集成晶体管也从800亿个增加到1040亿个/2080亿个,而同样基于Blackwell架构的RTX 50系列游戏GPU也会同步跨越。 发表于:2024/3/20 <…281282283284285286287288289290…>